题目
给你两个单链表的头节点 headA 和 headB ,请你找出并返回两个单链表相交的起始节点。如果两个链表不存在相交节点,返回 null 。
图示两个链表在节点 c1 开始相交 :
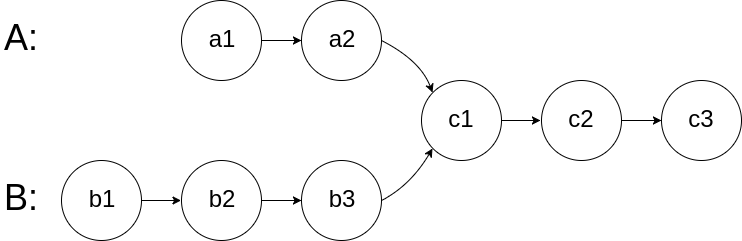
题目数据 保证 整个链式结构中不存在环。
注意,函数返回结果后,链表必须 保持其原始结构 。
自定义评测:
评测系统 的输入如下(你设计的程序 不适用 此输入):
intersectVal- 相交的起始节点的值。如果不存在相交节点,这一值为0listA- 第一个链表listB- 第二个链表skipA- 在listA中(从头节点开始)跳到交叉节点的节点数skipB- 在listB中(从头节点开始)跳到交叉节点的节点数
评测系统将根据这些输入创建链式数据结构,并将两个头节点 headA 和 headB 传递给你的程序。如果程序能够正确返回相交节点,那么你的解决方案将被 视作正确答案 。
示例 1:
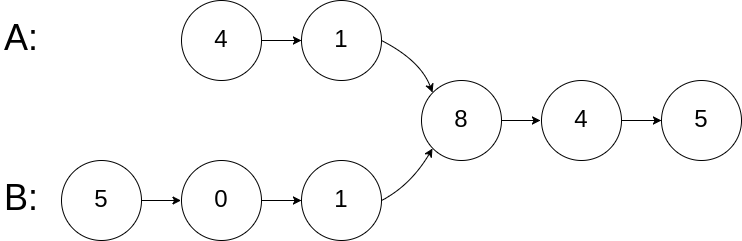
输入: intersectVal = 8, listA = [4,1,8,4,5], listB = [5,6,1,8,4,5], skipA = 2, skipB = 3 输出: Intersected at ‘8’ 解释: 相交节点的值为 8 (注意,如果两个链表相交则不能为 0)。 从各自的表头开始算起,链表 A 为 [4,1,8,4,5],链表 B 为 [5,6,1,8,4,5]。 在 A 中,相交节点前有 2 个节点;在 B 中,相交节点前有 3 个节点。 — 请注意相交节点的值不为 1,因为在链表 A 和链表 B 之中值为 1 的节点 (A 中第二个节点和 B 中第三个节点) 是不同的节点。换句话说,它们在内存中指向两个不同的位置,而链表 A 和链表 B 中值为 8 的节点 (A 中第三个节点,B 中第四个节点) 在内存中指向相同的位置。
示例 2:
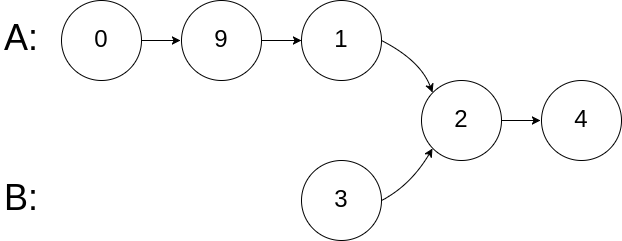
输入: intersectVal = 2, listA = [1,9,1,2,4], listB = [3,2,4], skipA = 3, skipB = 1 输出: Intersected at ‘2’ 解释: 相交节点的值为 2 (注意,如果两个链表相交则不能为 0)。 从各自的表头开始算起,链表 A 为 [1,9,1,2,4],链表 B 为 [3,2,4]。 在 A 中,相交节点前有 3 个节点;在 B 中,相交节点前有 1 个节点。
示例 3:
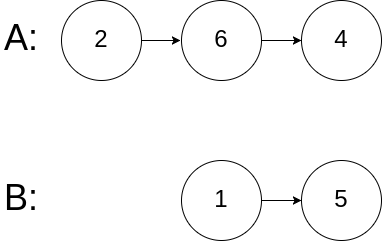
输入: intersectVal = 0, listA = [2,6,4], listB = [1,5], skipA = 3, skipB = 2 输出: No intersection 解释: 从各自的表头开始算起,链表 A 为 [2,6,4],链表 B 为 [1,5]。 由于这两个链表不相交,所以 intersectVal 必须为 0,而 skipA 和 skipB 可以是任意值。 这两个链表不相交,因此返回 null 。
我们只要返回指向相交点的指针。
题解
哈希
核心思想
先把链表 A 的所有节点指针(内存地址)全部存入哈希集合;再遍历链表 B,逐个拿 B 的节点去哈希集合里查找。第一个在集合中找到的节点,就是相交节点。
相交的本质:同一个内存地址的节点被两条链表同时指向,不是数值相等。哈希集合可以做到 时间复杂度查找某个节点是否已经出现过。
代码
/**
 * Definition for singly-linked list.
 * struct ListNode {
 *     int val;
 *     ListNode *next;
 *     ListNode(int x) : val(x), next(NULL) {}
 * };
 */
class Solution {
public:
    ListNode *getIntersectionNode(ListNode *headA, ListNode *headB) {
        unordered_set<ListNode*> st;
        ListNode* cur = headA;
        while(cur) {
            st.insert(cur);
            cur = cur -> next;
        }
        cur = headB;
        while(cur) {
            if(st.count(cur)) {
                return cur;
            }
            cur = cur -> next;
        }
        return nullptr;
    }
};时间复杂度:,A 遍历 m 个节点插入集合,B 遍历 n 个节点查询;哈希插入、查询平均。 空间复杂度: 需要存储链表 A 全部节点指针
长度对齐
核心思想
两条链表相交,相交之后的部分长度一定完全相同,区别只在于相交点之前的长度不一样。 先算出两条链表的长度,得到长度差;让长链表的指针先走完多出的那几段,把两个指针调整到距离末尾等距的位置。 之后两个指针同步一步一步往后走:
- 如果相交:第一个指针地址相等的节点,就是相交结点
- 如果不相交:两个指针会同时走到
NULL
代码
/**
 * Definition for singly-linked list.
 * struct ListNode {
 *     int val;
 *     ListNode *next;
 *     ListNode(int x) : val(x), next(NULL) {}
 * };
 */
int listSize(ListNode* head)
{
    ListNode* cur =head;
    int size = 0;
    while(cur) {
        size++;
        cur = cur->next;
    }
    return size;
}
class Solution {
public:
    ListNode *getIntersectionNode(ListNode *headA, ListNode *headB) {
        ListNode* curA = headA,* curB = headB;
        int numA = listSize(headA), numB = listSize(headB);
        int num = abs(numA -numB);
        if(numA - numB > 0) {
            while(num) {
                curA =curA->next;
                num--;
            }
        } else {
			while(num) {
                curB = curB->next;
                num--;
            }
        }
		while(curA != curB) {
			curA = curA->next;
			curB = curB->next;
		}
		return curA;
    }
};
时间复杂度: ,遍历两次求长度,再同步遍历一次 空间复杂度:,只使用指针、变量,不开额外容器
双指针
核心思想
两个指针分别从两个链表头出发向后遍历;当一个指针走到链表末尾 (nullptr),就切换到另一条链表的头部继续走。 两个指针走过的总路程永远相等:len(A)+len(B)。
- 如果链表相交:两个指针会在相交节点相遇
- 如果链表不相交:两个指针会同时走到 nullptr,循环结束返回 nullptr
本质:消除两条链表的长度差,让两个指针同步到达交点位置。
怎么理解相交链表的双指针
核心本质:不用手动算长度,自动抹平两个链表的长度差
设:
- 链表 A:不相交部分长度
a,公共相交部分长度c - 链表 B:不相交部分长度
b,公共相交部分长度c
链表 A 总长度:a + c 链表 B 总长度:b + c
指针行走路径
- pA:先走完整 A,再走完整 B → 总步数 =
- pB:先走完整 B,再走完整 A → 总步数 =
👉 两个指针走的总步数完全一样!
指针 A 的步数
A 先走完自己链表 headA:一共 步,到达
nullptr; 切换到 headB,在 B 链表上再往前走 步,抵达相交节点node。
总步数:
解释: a 是 A 的独有段; 是切换到 B 之后,走到交点需要走的步数。
指针 B 的步数
B 先走完 headB: 步,到nullptr; 切换到 headA,在 A 链表再走 步抵达交点node。
解释: b 是 B 的独有段; 是切换到 A 之后,走到交点需要走的步数。
等式
👉 两个指针步数完全相等,会同时到达相交节点node,于是 A == B。
两种情况拆解
情况 1:链表相交
总行走步数 ,两个指针同时落在相交节点,循环条件pA != pB不成立,直接返回交点。
情况 2:链表完全不相交
代入公式:
两个指针同样步数相等,最后同时走到 nullptr。 nullptr == nullptr,循环退出,返回nullptr。
此时公共长度 ,没有交点,两个指针同时到达末尾空。
代码
/**
 * Definition for singly-linked list.
 * struct ListNode {
 *     int val;
 *     ListNode *next;
 *     ListNode(int x) : val(x), next(NULL) {}
 * };
 */
class Solution {
public:
    ListNode *getIntersectionNode(ListNode *headA, ListNode *headB) {
        ListNode* pA = headA;
        ListNode* pB = headB;
        while(pA != pB) {
            pA = pA ? pA->next : headB;
            pB = pB ? pB->next : headA;
        }
        return pA;
    }
};
时间复杂度: ,最多遍历两条链表各一遍询 空间复杂度:,只使用两个指针,不需要额外容器
三种算法比较
| 解法 | 核心思路 | 时间复杂度 | 空间复杂度 | 优点 | 缺点 |
|---|---|---|---|---|---|
| 哈希集合 | 把 A 链表节点地址存入集合,遍历 B 查找是否存在 | O(m+n) | O(m) | 逻辑简单,直观好写 | 需要额外内存,不满足空间 O (1) 要求 |
| 长度对齐 | 计算两链表长度,长链表先走长度差,之后同步遍历找相同地址 | O(m+n) | O(1) | 逻辑容易理解,流程清晰 | 需要先遍历求长度,代码偏长 |
| 双指针 | 指针走到末尾切换到另一条链表头部,总路程都是 lenA+lenB | O(m+n) | O(1) | 无需计算长度,代码极简,最优解 | 需要理解路程相等的原理;链表有环会死循环 |