1 题目
给你一个长度为 n 的链表,每个节点包含一个额外增加的随机指针 random ,该指针可以指向链表中的任何节点或空节点。
构造这个链表的 深拷贝。 深拷贝应该正好由 n 个 全新 节点组成,其中每个新节点的值都设为其对应的原节点的值。新节点的 next 指针和 random 指针也都应指向复制链表中的新节点,并使原链表和复制链表中的这些指针能够表示相同的链表状态。复制链表中的指针都不应指向原链表中的节点 。
例如,如果原链表中有 X 和 Y 两个节点,其中 X.random --> Y 。那么在复制链表中对应的两个节点 x 和 y ,同样有 x.random --> y 。
返回复制链表的头节点。
用一个由 n 个节点组成的链表来表示输入/输出中的链表。每个节点用一个 [val, random_index] 表示:
val:一个表示Node.val的整数。random_index:随机指针指向的节点索引(范围从0到n-1);如果不指向任何节点,则为null。
你的代码 只 接受原链表的头节点 head 作为传入参数。
示例 1:
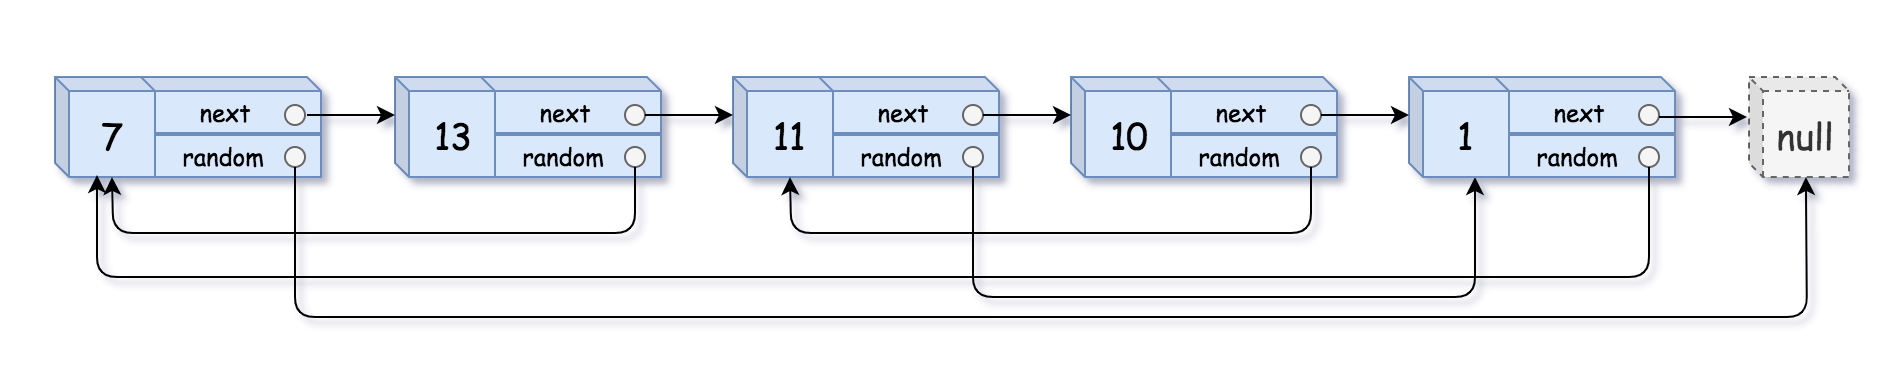
输入: head = [[7,null],[13,0],[11,4],[10,2],[1,0]] 输出:[[7,null],[13,0],[11,4],[10,2],[1,0]]
示例 2:
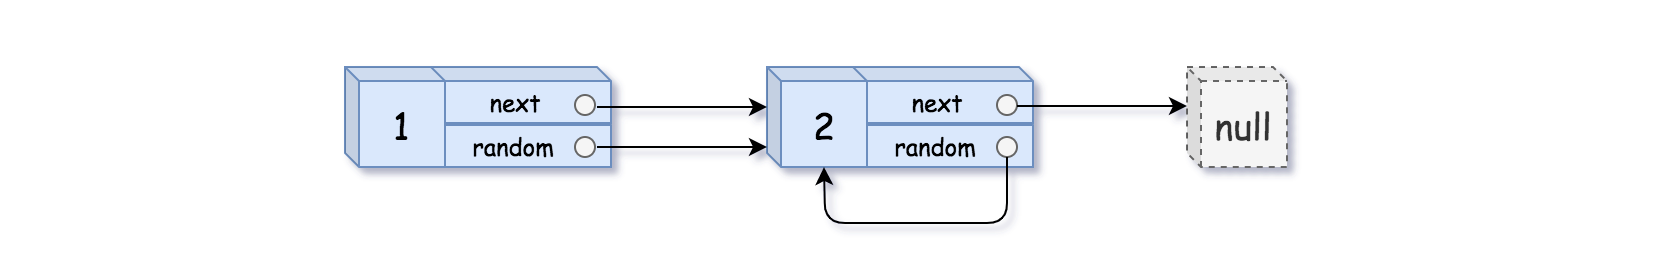
输入: head = [[1,1],[2,1]] 输出:[[1,1],[2,1]]
示例 3:

输入: head = [[3,null],[3,0],[3,null]] 输出:[[3,null],[3,0],[3,null]]
2 题解
2.1 哈希表
2.1.1 核心思想
建立「原节点对象」到「新拷贝节点对象」的一一映射关系。 map[原节点指针] = 新拷贝节点指针
链表难点在于:random 可以指向前面、后面、自己、null。 遍历的时候,访问到一个节点,它的 random 指向的节点可能还没有创建出来,不能一边创建一边直接赋值 random。
哈希表分两轮遍历解决这个问题:
- 第一轮:只造节点,不连指针 遍历原链表,每遇到一个原节点,就 new 一个值相同的新节点,存入哈希表。
这一步只填充
val,next、random全部不管。 效果:所有新节点全部创建完毕,不管 random 指向哪里,对应的拷贝节点已经存在哈希表里。
- 第二轮:利用映射关系,补全 next 和 random 拿到原节点
cur:
- 拷贝节点 =
mp[cur] - 拷贝节点的 next =
mp[cur->next] - 拷贝节点的 random =
mp[cur->random]
因为全部节点已经提前建好,不管 cur->next / cur->random 是哪个节点,直接查表就能拿到它对应的拷贝版本。 unordered_map 当 key 是 nullptr 时,返回 value 也是 nullptr,空指针天然处理。
2.1.2 代码
/*
// Definition for a Node.
class Node {
public:
    int val;
    Node* next;
    Node* random;
    Node(int _val) {
        val = _val;
        next = NULL;
        random = NULL;
    }
};
*/
class Solution {
public:
    Node* copyRandomList(Node* head) {
        if(head == nullptr) return nullptr;
        unordered_map<Node*, Node*> mp;
        Node* cur = head;
        while(cur != nullptr) {
            mp[cur] = new Node(cur->val);
            cur = cur->next;
        }
        cur = head;
        while(cur != nullptr) {
            mp[cur]->next = mp[cur->next];
            mp[cur]->random = mp[cur->random];
            cur = cur->next;
        }
        return mp[head];
    }
};
2.1.3. 复杂度
时间复杂度:,两次遍历链表,哈希查询 空间复杂度:,哈希表存储 n 个节点映射
2.2 原地拼接拆分
2.2.1 核心思想
不额外开哈希表存映射,把拷贝节点直接插入在原节点的后面,形成混合链表。 利用位置关系实现映射:
原节点的下一个节点,就是它对应的拷贝节点
copy_node = original_node->next
原始:A → B → C 插入后:A → A' → B → B' → C → C'
这样就不需要哈希表,通过指针位置就能找到原节点对应的拷贝节点。
整体分三大步骤:
① 复制插入:构建混合链表
遍历原链表,每一个原节点后面插入自己的拷贝节点。 新节点只复制val,next、random暂时不处理。
A的next指向A',A'的next指向原来A->next(B)结果链表:A → A' → B → B' → C → C'
② 设置拷贝节点的 random
原节点 A 的 random 指向 X;那么拷贝节点 A’ 的 random 就应该指向 X’。 而 X' = X->next,这就是核心公式:
if(cur->random != nullptr)
cur->next->random = cur->random->next;cur:原节点cur->next:它的拷贝节点 A’cur->random:原节点 random 指向的 Xcur->random->next:X 对应的拷贝 X’
⚠️必须判空:如果
cur->random是nullptr,直接跳过,A’.random 默认为 nullptr。
③ 拆分链表
把混合链表拆回两条独立链表:
- 原链表:
A → B → C(恢复原来结构) - 拷贝链表:
A' → B' → C'(就是我们要返回的深拷贝结果)
拆分规则:
cur走原节点,copyCur走拷贝节点cur->next = cur->next->next跳过拷贝节点,恢复原链表copyCur->next = copyCur->next->next跳过原节点,拼接拷贝链表
2.2.2 代码
/*
// Definition for a Node.
class Node {
public:
    int val;
    Node* next;
    Node* random;
    Node(int _val) {
        val = _val;
        next = NULL;
        random = NULL;
    }
};
*/
class Solution {
public:
    Node* copyRandomList(Node* head) {
        if(head == nullptr) return nullptr;
        Node* cur = head;
        while(cur != nullptr) {
            Node* copy = new Node(cur->val);
            copy->next = cur->next;
            cur->next = copy;
            cur = copy->next;
        }
        cur = head;
        while(cur != nullptr) {
            if(cur->random != nullptr) {
                cur->next->random = cur->random->next;
            }
            cur = cur->next->next;
        }
        cur = head;
        Node* copyHead = head->next;
        Node* copyCur = copyHead;
        while(cur != nullptr) {
            cur->next = cur->next->next;
            cur = cur->next;
            if(copyCur->next != nullptr) {
                copyCur->next = copyCur->next->next;
                copyCur = copyCur->next;
            }
        }
        return copyHead;
    }
};
2.2.3 复杂度
时间复杂度:,三次遍历链表 空间复杂度:,拷贝出来的输出链表不计入额外空间,没有哈希表等辅助存储。
2.3 两种算法对比
| 对比项 | 哈希表法 | 原地拼接拆分法 |
|---|---|---|
| 映射手段 | 哈希表:原节点 → 拷贝节点 | 利用链表位置:原节点->next = 拷贝节点 |
| 时间复杂度 | O(n),2 次遍历 | O(n),3 次遍历 |
| 额外空间 | O(n)(哈希表) | O(1),输出链表不计额外空间 |
| 代码难度 | 简单,逻辑直观,空指针少 | 较难,细节多,容易空指针崩溃 |
| 原链表 | 不会修改原链表 | 中间会修改原链表,最后拆分恢复原链表 |
| 核心难点 | 理解为什么要两轮遍历 | 记住公式 cur->next->random = cur->random->next,拆分边界处理 |
| 面试建议 | 写代码优先选这个,不容易 bug | 面试官追问空间优化时再写 |